文脈ウィンドウに何が入っているのか、図にした
「長い文章を貼っていないのに枠が足りない」理由を図で整理しました。入力も出力も同じ1つの枠に入ります。公式ドキュメントの記述に基づく解説です。
この記事の結論
- 入力も出力も、同じ1つの枠に入る。本文以外も全部数えられる
- やり取りは消えずに積み上がる。毎回それまで全部を読み直させている
- 枠に入ることと、精度が保たれることは別
- 入力も出力も、同じ1つの枠に入る。本文以外も全部数えられる
- やり取りは消えずに積み上がる。毎回それまで全部を読み直させている
- 枠に入ることと、精度が保たれることは別
「そんなに長い文章は貼っていないのに、途中から答えが雑になる」。これが起きる理由は、枠に入っているものが本文だけではないことにある。文章で説明すると分かりにくいので、図にした。
ここから書くことは、すべて提供元の公開ドキュメントに書かれている内容に基づく。出典は末尾に置いた。
文脈ウィンドウとは何か
公式ドキュメントの定義はこうだ。
「文脈ウィンドウ」とは、モデルが返答を作るときに参照できるすべての文章を指す。返答そのものも含む。
そして、学習したデータとは別物であり、その場の「作業記憶」にあたると説明されている。
ここで大事なのは「返答そのものも含む」という一文だ。入力だけの話ではない。
1回の問いかけで、何が数えられるか
1回のやり取りで枠を使うものを並べると、こうなる。
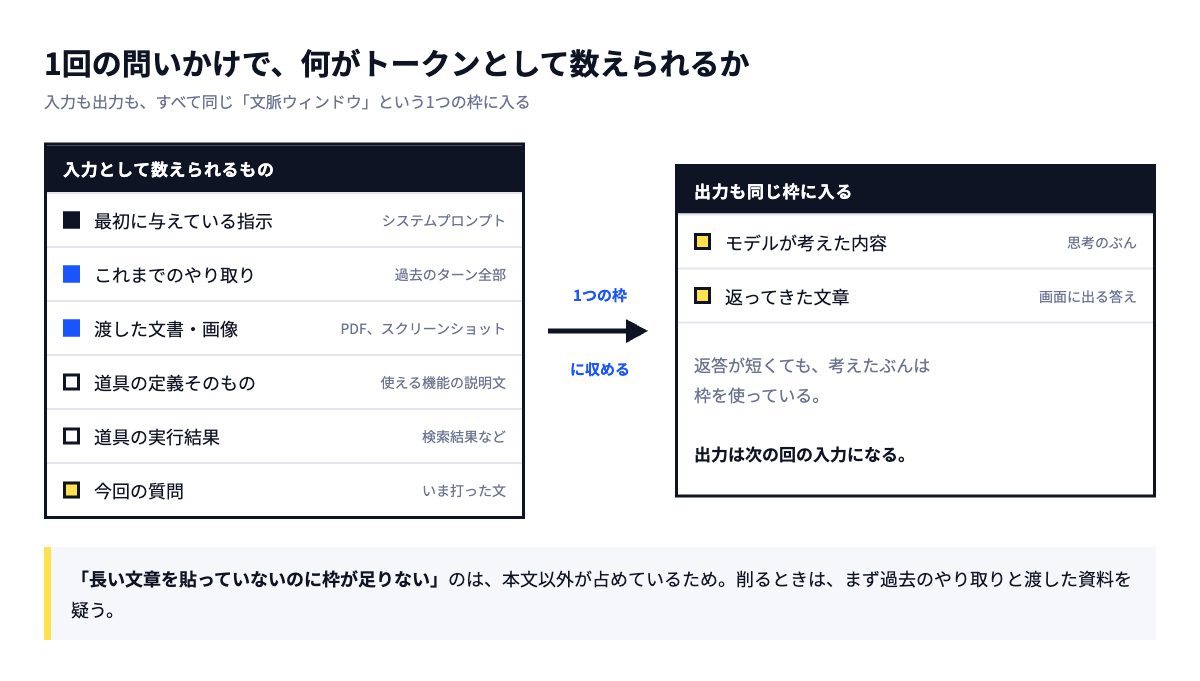
ドキュメントは「リクエストに含まれるすべてが文脈ウィンドウに数えられる」として、次を挙げている。
- 最初に与えている指示(システムプロンプト)
messagesのすべてのメッセージ(道具の実行結果、画像、文書を含む)- 使える道具の定義そのもの
さらに「そのターンでモデルが生成した出力も、考えた内容を含めて数えられる」と続く。
ここが見落とされやすい
画面に出ているのは「自分が打った文」と「返ってきた文」だけだ。その裏にある最初の指示、道具の定義、考えた内容は見えない。見えないものが枠を使っている。
長い資料を渡したのに効果が薄いときは、本文を削るより先に資料以外が何を占めているかを疑うことになる。渡し方そのものは長い文書を読ませるときの渡し方に書いた。
やり取りを重ねると、積み上がる
1回で終わらない場合、前のやり取りは消えない。ドキュメントにはこうある。
会話がターンを重ねるにつれ、利用者の各メッセージとアシスタントの応答が文脈ウィンドウの中に蓄積し、前のターンは完全に保持される。
つまり10回目の質問を投げるとき、1回目から9回目までの全部を、もう一度読ませている。
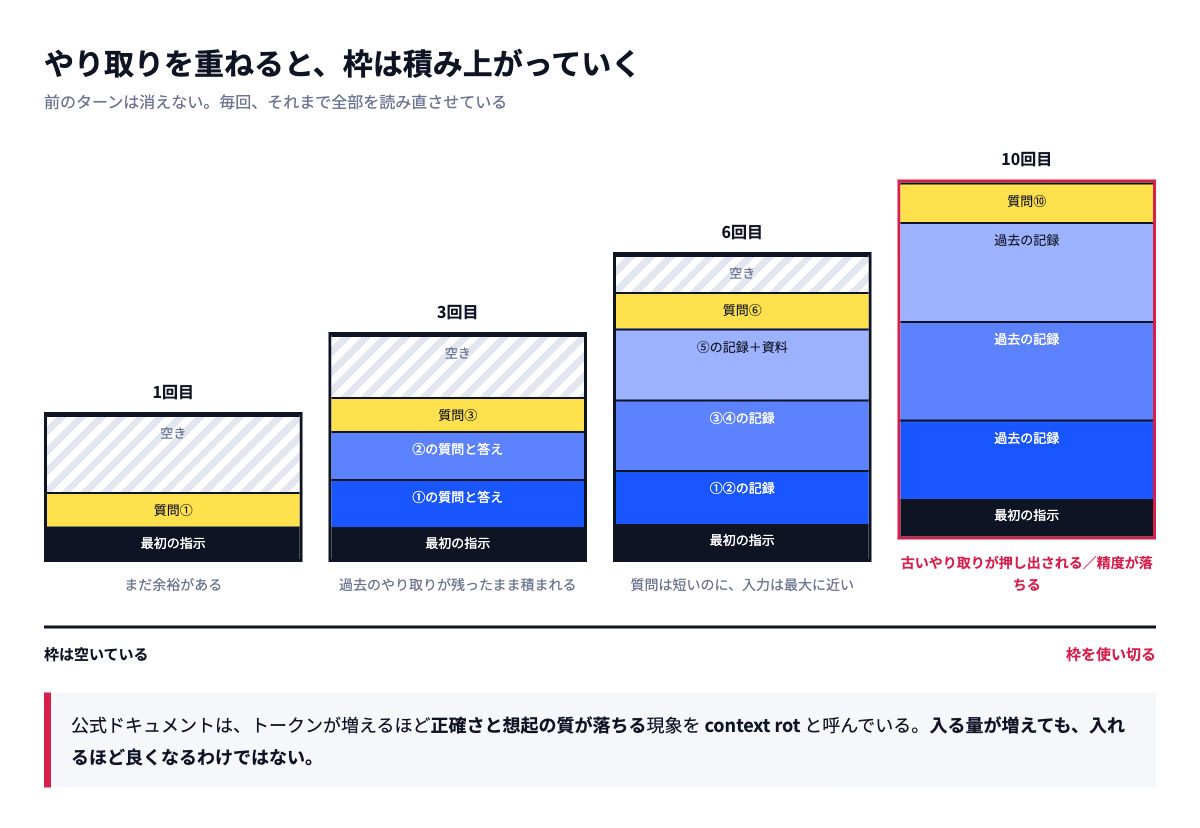
図の黄色が、その回に打った質問だ。打った量は毎回ほとんど変わらないのに、枠は埋まっていく。「同じように使っているのに後半だけ調子が悪い」と感じる正体がこれになる。
チャット画面では、古いものが静かに落ちる
ドキュメントには注記がある。claude.ai のようなチャット画面は、文脈を先入れ先出しで入れ替えて管理することがある。
APIなら上限を超えた時点でエラーになるが、チャット画面では何も言わずに古いやり取りが落ちる。「さっき伝えた前提を忘れている」のは、忘れたのではなく押し出されている場合がある。
枠に入ることと、精度は別
ここが本題だ。ドキュメントはこう書いている。
大きな文脈ウィンドウがあれば複雑で長いプロンプトを扱えるが、文脈は多ければ良いというものではない。トークン数が増えるにつれて、正確さと想起の質が落ちる。これは context rot と呼ばれる現象である。
そして「使える容量がどれだけあるかと同じくらい、文脈に何を入れるかを選ぶことが重要になる」と締めている。
渡せる量が増えたからといって、全部渡すのが正解にはならない。やり取りが長くなると答えが悪くなる。区切り直す目安を決めたで書いた体感には、名前が付いていたことになる。
実際の数字
感覚で話すと誤解しやすいので、公表されている値を置いておく。
| 項目 | 値 |
|---|---|
| 文脈ウィンドウ | 100万トークン(現行のClaude各モデル) |
| 100万トークンの目安 | 約55万5千語/約250万文字 |
| 1回の返答の上限 | 12万8千トークン |
| 1回に含められる画像・PDFのページ | 最大600枚 |
250万文字というのは、文庫本にすればかなりの冊数になる。「入らない」で困る場面は、実務ではほとんど無い。困るのは、入れすぎて精度が落ちる側だ。
なお、入力だけで上限を超えた場合は400番のエラー(prompt is too long)が返る。
削るときの順番
図1の左側を、占める量が大きい順に見ていく。
- 過去のやり取り — 回を重ねるほど最大になる。新しく始め直すのが最も効く
- 渡した文書と画像 — 全部ではなく必要な節だけ渡す
- 道具の定義 — 使わない機能を外す
- 最初の指示 — 短くできるが、理由を書いた一文は残す。削ると指示の精度が落ちる
1番から手を付ける。長くなった会話を続けるより、要点を持って新しく始めるほうが速い。区切り方はやりとりが長くなったときの扱いに書いた。
仕組みの側にも対処がある
手で区切り直す代わりに、仕組みに畳ませる方法も用意されている。ドキュメントは compaction(圧縮) を「長く続く会話とエージェントの作業における、文脈管理の主な手段」と位置づけ、会話の前半をサーバー側で自動的に要約して、上限を超えても続けられるようにすると説明している。
やっていることは、人が要点をまとめて新しく始めるのと同じだ。違うのは、その要約を自分で作るか仕組みに任せるかだけになる。
前置きを使い回しても、枠は空かない
同じ指示を毎回使っている場合、2回目以降の読み出しは安くなる仕組みがある。ただしドキュメントは明記している。
使い回した前置きも、文脈ウィンドウは占めたままになる。変わるのは何に対して支払うかであって、枠に数えられるかどうかではない。
費用の話と、枠の話は別だ。
投げる前に見積もる
「入るかどうか」を事前に知る手段も用意されている。送る前にトークン数を数えるAPIがあり、ドキュメントでもリクエストを送る前の見積もりに使うよう案内されている。
また、返ってきた応答には毎回 usage という欄があり、そのリクエストが何を消費したかが分かる。感覚ではなく数字で確かめられる。
図にして分かったこと
文章で読んでいたときは「長いと悪くなるらしい」程度の理解だった。並べてみると、短い質問を打っているときほど、見えない部分の割合が大きいという形になっているのが分かる。
要約が抜ける話も同じ構造だ。長い文章を要約させると大事なところが抜ける。防ぐために変えた頼み方で書いた現象は、枠の中で何が優先されるかの問題として見ると理解しやすい。
まとめ
- 文脈ウィンドウは返答そのものも含む、その場の作業記憶
- 最初の指示、道具の定義、考えた内容まで数えられる。画面に見えていないものが枠を使う
- やり取りは消えずに積み上がる。毎回それまで全部を読み直させている
- チャット画面では、古いやり取りが何も言わずに落ちることがある
- トークンが増えるほど正確さと想起の質が落ちる(context rot)
- 100万トークン=約250万文字。入らないより、入れすぎのほうが問題になる
- 削る順番は、過去のやり取り → 渡した資料 → 道具の定義 → 最初の指示
出典
図は本記事のために作成したもので、上記の記述をもとに構成している。仕様は変わるため、実装の前に各ページで最新の内容を確認すること。本記事は2026年10月13日時点の内容に基づく。
関連記事
RELATED
長い文書を読ませるときの渡し方
全部渡すと浅くなるので、分けて渡すようにしました。
候補を出してもらって、自分で選ぶ使い方
1つの答えを求めるより、候補を並べてもらうほうが使えました。
半年使った上で、最初に戻って勧めること
これから始める人に、何から伝えるか考えました。