埋め込みベクトルの仕組みを、図にした
文章を数の並びに変えると、意味の近さを距離で測れるようになります。キーワードが一致しない検索ができる理由を図で整理しました。
この記事の結論
- 文章を、決まった個数の数値の並びに変える
- 意味が近い文は、その空間で近い場所に来る
- だから単語が一致しなくても探せる
- 文章を、決まった個数の数値の並びに変える
- 意味が近い文は、その空間で近い場所に来る
- だから単語が一致しなくても探せる
「キーワードが違うのに、ちゃんと関連する文書が出てくる」。あれを支えているのが埋め込み(embedding)だ。言葉で説明すると抽象的になるので、図にした。
何をしているのか
やっていることは単純で、文章を数の並びに変える。公式ドキュメントの説明では、埋め込みは「意味的な近さを測れるようにする、テキストの数値表現」とされている。
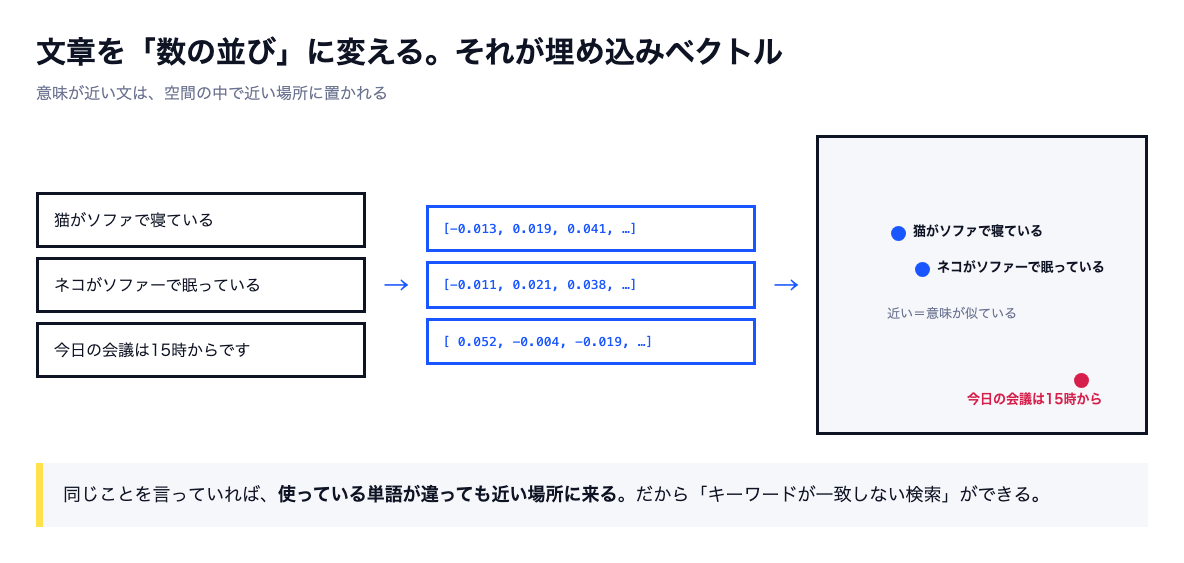
図の左と右で、使われている文字はまるで違う。「猫」と「ネコ」、「寝て」と「眠って」。文字列として比べると一致率はかなり低い。それでも数に変換すると近い場所に来る。
数はいくつ並ぶのか
具体的な値が公表されている。よく使われるモデルでは、1つの文章が1024個の小数になる(設定で256・512・2048も選べる)。扱える入力の長さは3万2千トークンまで。
この1024という数は文章の長さに関係なく一定だ。1行でも1000行でも、出てくるのは同じ個数の並びになる。だから長さの違う文書どうしを同じ土俵で比べられる。
近さはどう測るのか
公式ドキュメントには、コサイン類似度・内積・ユークリッド距離のいずれも使えると書かれている。そのうえで、こういう注記がある。
埋め込みは長さ1に正規化されている。そのためコサイン類似度と内積は同じ結果になり、内積のほうが速く計算できる。
実装としては、ベクトルどうしを掛けて足すだけになる。意味の比較が、算数の計算に置き換わっているのがこの仕組みの要点だ。
質問と文書で、埋め込み方を変える
見落としやすい設定がある。検索に使う場合、質問側と文書側で指定を変えるよう案内されている。
ドキュメントによれば、この指定に応じて、埋め込む前に内部で短い前置きが付け足される。質問には「補足文書を探すための質問として表現せよ」、文書には「検索のための文書として表現せよ」といった文だ。
省略すると精度が落ちるとされている。同じ文章でも、質問として扱うか文書として扱うかで置かれる場所が変わるということになる。
保存の量を減らす仕組み
1024個の小数を文書の数だけ持つと、量が増える。これに対する手段も用意されている。
- 精度を落とす … 32ビットの小数を8ビットの整数にすると4分の1、1ビットの二値にすると32分の1になる
- 短く切る … 先頭の一部だけ残して正規化し直す。1024個を256個に減らせる
後者が成立するのは、前のほうの数字ほど大まかな意味を担う作りになっているためだ。粗い情報から細かい情報へ順に並んでいるので、後ろを切っても意味の大枠は残る。
トークンとは別の話
混ざりやすいので分けておく。
| トークン | 埋め込み | |
|---|---|---|
| 何を数える/作る | 文章を区切った単位 | 文章1つを表す数の並び |
| 長さとの関係 | 長い文章ほど多い | 長さによらず一定 |
| 使いみち | 枠の計算、料金の計算 | 近さの比較、検索 |
埋め込みを作るときにも入力はトークンとして数えられるが、出てくるものは別物だ。
何に使えるのか
- 検索 … 言い回しが違っても探せる
- 分類 … 近いもの同士をまとめる
- 推薦 … いま見ているものに近いものを出す
- 異常の検出 … どこからも遠いものを見つける
このサイトで内部リンクを張ったときも、考え方としては同じ方向の作業をしている。記事の抜粋とタグから近さを測り、近い記事を候補に出した。
調べ物の入口として使うときも同じ
手元の資料から該当箇所を引いてくる仕組みは、この近さの計算で動いている。引いてきた箇所が本当に答えになっているかは別問題なので、確認の手順は要る。やり方は知らない分野を調べるとき、AIを入口にして失敗しない手順に書いた。
提供元について
ひとつ実務的な注記がある。公式ドキュメントには「Anthropicは自社の埋め込みモデルを提供していない」と明記されており、別の提供元を使うよう案内されている。
文章を生成する機能と、埋め込みを作る機能は別の会社から調達することになる場合がある。契約とデータの扱いを確認する相手が増えるという意味で、設計の前に知っておくほうがよい。
まとめ
- 埋め込みは、文章を決まった個数の数値の並びに変えたもの
- よく使われる設定で1024個。文章の長さによらず一定
- 長さ1に正規化されているので、内積とコサイン類似度が一致する
- 検索では質問側と文書側で指定を分ける。省くと精度が落ちる
- 精度を落とす・短く切ることで、保存量を4分の1や32分の1にできる
- トークンとは別物。長さに比例しないのが決定的な違い
出典
- Anthropic「Embeddings」(次元数、正規化、input_type、量子化、次元の切り詰め)
図は本記事のために作成したもの。モデルと仕様は変わるため、実装前に最新の記載を確認すること。本記事は2026年10月13日時点の内容に基づく。
新しい記事が出たら、ブラウザの通知でお知らせします。
メールアドレスの登録は要りません。いつでも止められます。
関連記事
RELATED
圧縮できるのは、冗長度があるから。情報の量の測り方を図にした
情報の量は意味では測りません。どれだけ絞り込めたかで測ります。1948年の論文が置いた定義と、英語の冗長度が約50%とい…
HOKKAIDO AI LAB を英語でも読めるようにしました。ボタン1つで翻訳、英語のページを作らなかった理由も
海外から読んでくださる方のために、ヘッダーに英語の翻訳ボタンを付けました。押すと、いま見ているページがその場で英語になり…
相席か個室か。1つの仕組みを何社で使うかを図にした
共有するか分けるかは0か1ではありません。層ごとに決められます。4つの構成と、それぞれで何を引き受けることになるのかを整…